模型大小和显存关系
*** 次数不足,请联系开发者***

8GB 显存即可运行:5.8B 图像生成模型 FLUX 3 Image Klein 发布这款模型的 INT8 版本可通过 ComfyUI 或 Diffusers 在仅配备 8GB 显存的 NVIDIA GeForce RTX GPU 上运行。根据测试,精简后的 INT8 版本在 GeForce RTX 5090 上生成 1MP 的图像大约需要 4s,在 GeForce RTX 4070 上通过 ComfyUI 生成 1MP 图像不到 9s。FLUX 3 Image Klein 支持...
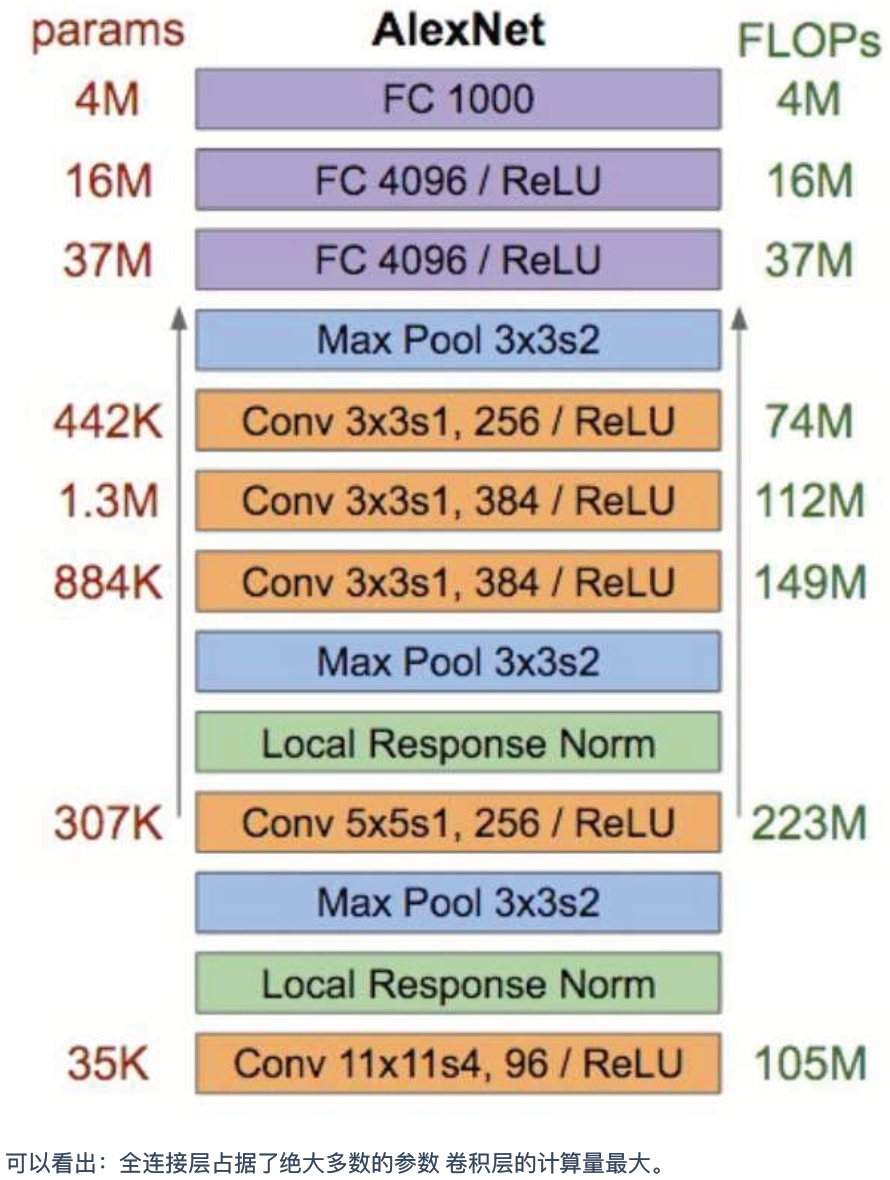
不用微调、不刷显存:清华黑科技让大模型‘看一眼就会’,1-shot效果超... 以前做提示工程,总在纠结:到底塞几个例子进prompt才够?塞少了怕模型懵,塞多了又卡——token爆了、显存炸了、推理慢得像... 而是一道“用除法解分配问题”的抽象题——表面不相关,但触发的是同一套思维齿轮。 这事儿其实早有苗头。去年Google的S...

⊙0⊙ 英伟达 DLSS 5 最新模型 10 月 16 日推送:性能相比 9 月翻倍,4K 显存...IT之家 10 月 13 日消息,英伟达官方刚刚宣布,DLSS 5 的 3D 引导神经渲染模型将在本周迎来重大性能更新,新的模型将于 10 月 16 日正式推送。英伟达表示,通过系统性优化处理流程和改进神经网络模型,新版本的运行性能将提升至 9 月首发版本的 2 倍,同时将 4K 游戏场景下的显存占用...
给大模型装一个"记忆压缩器":WUSH-KV如何用数学方式省显存存在显存里,随时准备拿出来用。这组被存起来的东西,业内叫它KV缓存。*KV缓存:*大模型在生成文字时,会把每个已经处理过的词转换成两类... *Gram矩阵:*衡量一组向量彼此之间相关性和能量大小的矩阵,这里用来描述被量化数据本身的统计特征。*Hessian矩阵:*原本是描述函数曲率的...
●^● 
砍价砍到六折!网友250元捡漏9卡废旧矿机:54GB显存能跑70B模型快科技10月7日消息,近日一位Reddit网友发帖分享自己的捡漏经历,他在俄罗斯二手交易平台Avito上,以约3000卢布(约250元人民币)的价格购入了一台搭载9张显卡的退役矿机,利用其54GB的总显存成功运行了本地AI模型。这套矿机上安装了9张P106显卡。P106是GTX 1060的挖矿专用...

12GB 显存显卡跑 125B 模型:Strata 登场IT之家 10 月 6 日消息,科技媒体 gigazine 今天(10 月 6 日)报道,报道称开发者 Niko1221 开源推出 Strata 引擎,可以在 12GB 及以上显存的消费级显卡上,运行量化的 Qwen3.8-Flash-Next 模型(1250 亿参数)。IT之家注:Qwen3.8-Flash-Next 模型是阿里巴巴 Qwen 团队于 2026 年 8 月推出的多...

华为升腾突破 MoE 模型无损显存优化技术瓶颈,显存占用减半稀疏架构凭借兼顾模型容量与计算效率的优势,成为 AI 领域核心研究方向。在此背景下,南京大学李猛博士团队,依托南京大学鲲鹏升腾科教创新孵化中心的算力支持,基于华为升腾,开展专家等价性驱动的 MoE 无损显存高效优化研究,成功攻克系列技术瓶颈,实现显存消耗降低 50% 以上、...
行云科技:唐博团队技术旨在优化大模型推理显存和传输开销唐博教授团队相关技术旨在优化大模型推理显存和传输开销,理论上可提升单卡 Token 产出效率、压降推理成本。特别风险提示:双方合作起步不久,技术在公司硬件体系内测试工作刚启动,我司暂无充足实测数据证实网传 “单卡 token 产出效率提升 5-10 倍” 可落地兑现;该项目研发适配...
+^+ 
高德发布首个无长程依赖的万帧级流式3D重建模型ABot-Recon,显存降...但是该技术会受到误差累积和显存过大等一系列问题的影响。为了保持长距离场景的全局一致,传统的流式3D重建会在重建中设置记忆锚点,模型需要依赖长程记忆不断保存、检索和融合历史信息。当序列越长时,模型的速度越慢、精度越差、显存越高。ABot-Recon选择了一条全新的技...
+ω+ 英特尔酷睿 Ultra 200H 支持 120GB 显存,可运行 120B MoE 模型而现在可将至多 120GB 智能分配为动态显存,支持 120B 大参数 MoE 模型的运行。其中酷睿 Ultra 9 285H 平台已广泛兼容 Qwen 3-30B-A3B、Qwen 3-Next-80B-A3B、GPT OSS-120B/20B 等主流 MoE 模型以及多种稠密模型,而通过雷电互联双机集群能进一步实现 235B 参数模型本地...
(°ο°) 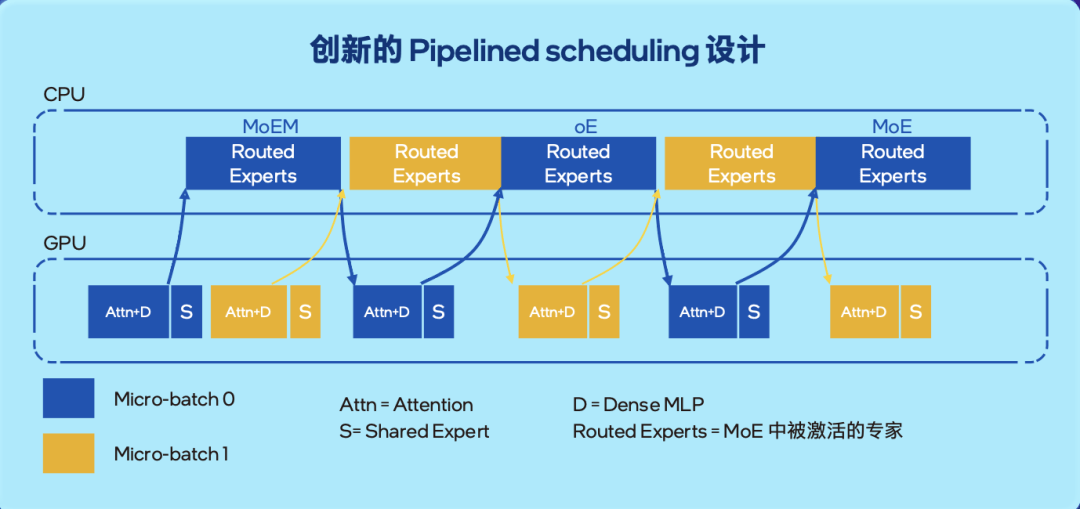
西柚加速器部分文章、数据、图片来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知删除。邮箱:xxxxxxx@qq.com
上一篇:模型大小和显存关系
下一篇:模型大小和显存大小对应吗


