视频加文本_视频加文本
*** 次数不足,请联系开发者***
一、视频加文本朗读
国家反诈中心上线 AI 内容鉴定功能,可辨图像、视频、文本等内容IT之家 3 月 12 日消息,国家反诈中心 App 迎来升级,新上线了 AI 内容鉴定功能。IT之家实测,国家反诈中心的 AI 内容鉴定功能支持图像、视频、文本、音频的 AI 内容检测。使用时需按照对应模块上传具体的内容。其中,图片限制大小 30KB~5MB、视频限制 100KB~100MB、文本限制 10...
二、视频加文本怎么分段

三、视频加文本框的四种方法
?0? 音视频+文本原生融合!字节新模型SeedRealtime三大突破详解音视频和文本在同一个神经网络里跑,时序对齐、语义互通,连“啊?”“嗯?”这种语气词和画面里的点头动作都能联动判断。 它真正在乎的,是“别打断我”“别晾着我”“别听错我”。比如你正指着屏幕里一只猫说“它刚跳上沙发”,SeedRealtime不会只盯着“猫”字...
四、视频文本是什么意思
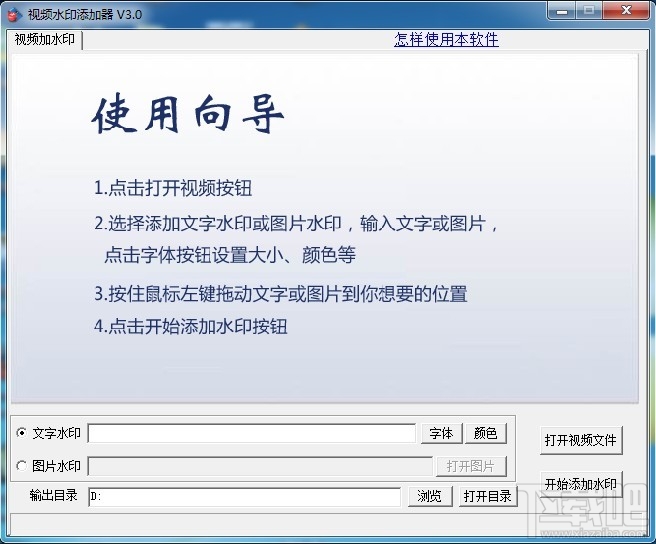
五、视频文本生成器下载
╯▂╰ 人民网获得发明专利授权:“一种融合视频画面和场景文本信息的跨...证券之星消息,根据天眼查APP数据显示人民网(603000)新获得一项发明专利授权,专利名为“一种融合视频画面和场景文本信息的跨模态视频正能量评价方法、系统及计算机存储介质”,专利申请号为CN202311018030.0,授权日为2026年5月8日。专利摘要:一种融合视频画面和场景文本...
六、视频加文字

七、视频加文字下载
⊙0⊙ 通义视频生成模型Wan2.7-Video上线:支持文本、图像、视频、音频全...凤凰网科技讯 4月3日,近日,视频生成模型Wan2.7-Video正式上线。该模型支持文本、图像、视频、音频全模态输入,聚焦视频生成后的编辑与修改能力,旨在让视频内容像文档一样可编辑。在视频编辑方面,Wan2.7支持通过指令对画面进行局部调整,无需重新生成完整片段。具体功能包括...
八、视频加文字配音

SRM理工学院发布:文本到视频生成技术演进图谱这项由印度SRM理工学院计算智能系的Nilay Kumar、Priyansh Bhandari和G. Maragatham教授共同完成的综合性研究发表于2025年10月的arXiv预印本平台,论文编号为arXiv:2510.04999v1。该研究首次系统性地梳理了文本到视频生成技术的完整发展脉络,为这个快速发展的人工智能领...
●▂● 
Runway发布Gen-4.5文本生成视频模型,号称性能超越Sora 2与Veo 3AIPress.com.cn报道12月5日消息,Runway 在纽约正式发布全新的文本生成视频模型 Gen-4.5,并高调宣称其在综合表现上已经超越 OpenAI 的 Sora 2 和 Google 的 Veo 3。根据官方博客介绍,这一代模型具备更高视觉逼真度、更强创作控制能力,能够生成电影级、细节丰富的动态画面,甚至...
Google Photos新增文本提示视频生成功能,支持音频默认添加谷歌相册最近又放大招啦!2026年1月28日发布的更新里,给用户带来了更强的生成式AI图片转视频控制能力。现在大家能用文本提示来描述想要... 当时就打算让用户通过自定义提示词直接控制AI视频生成方向,在图片转视频界面底部加了提示词输入框,让大家能自由输入指令生成个性化短视...

谷歌多模态新模型:让文本图像视频音频共处同一空间2026年3月11日,谷歌搞出了个大新闻——发布了首个原生多模态嵌入模型Gemini Embedding 2。这玩意儿厉害在哪儿?简单说,它能把文本、图像、视频、音频和文档全都扔进同一个“向量空间”里,就像把不同语言的书翻译成同一种密码,让AI第一次能真正“跨物种”理解信息。打个比...
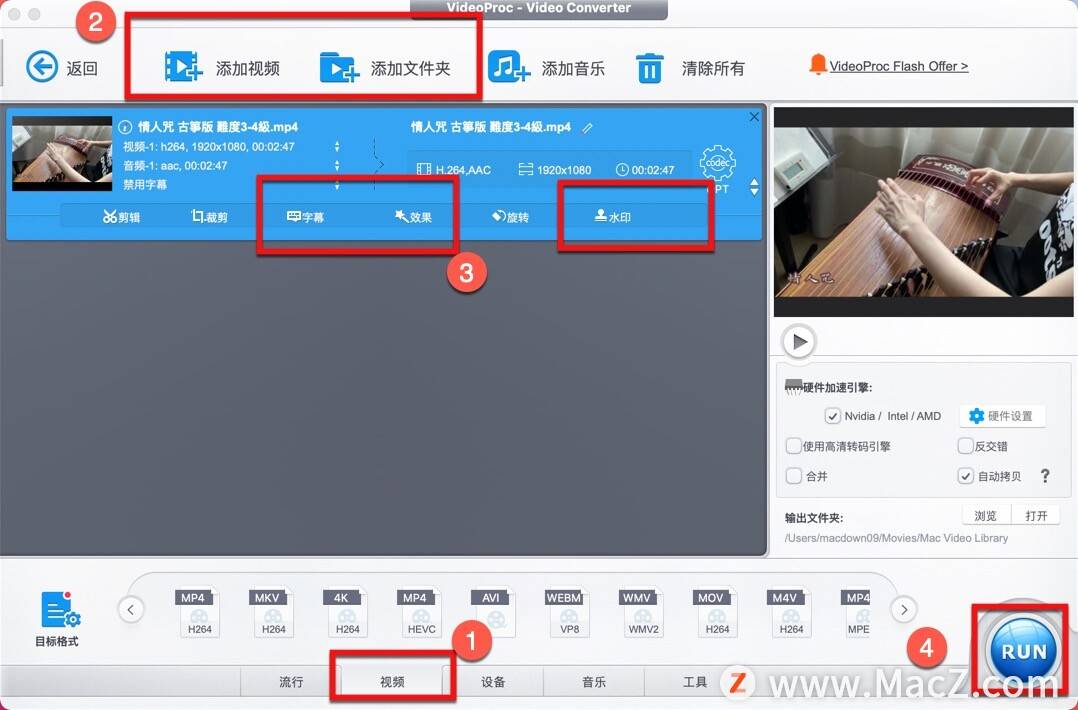
让龙虾看懂屏幕!谷歌多模态新成果,文本图像视频音频进同一空间henry 发自 凹非寺量子位 | 公众号 QbitAI原生,启动!刚刚,谷歌发布了首个原生多模态(Multimodal)嵌入模型——Gemini Embedding 2。这次模型最大的变化在于:把文本、图像、视频、音频和文档,全部映射进同一个统一的嵌入空间。换句话说,不同媒介的数据第一次被放进同一个语义坐标...

...方向包括电影AI译制、AI技术在电影文本和音视频内容方面的应用等AI技术在电影文本和音视频内容方面的应用等。谢谢关注。投资者:董秘你好!贵公司是否参与出品电影(转念花开)?谢谢中国电影董秘:您好。截至目前,公司未参与上述影片的投资出品。谢谢关注。投资者:董秘你好!贵公司是否参与博纳AI电影(三星堆)?谢谢中国电影董秘:您好。截至目前...
ˋ^ˊ〉-# 
西柚加速器部分文章、数据、图片来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知删除。邮箱:xxxxxxx@qq.com


