爬虫网页数据采集_爬虫网页数据采集
*** 次数不足,请联系开发者***

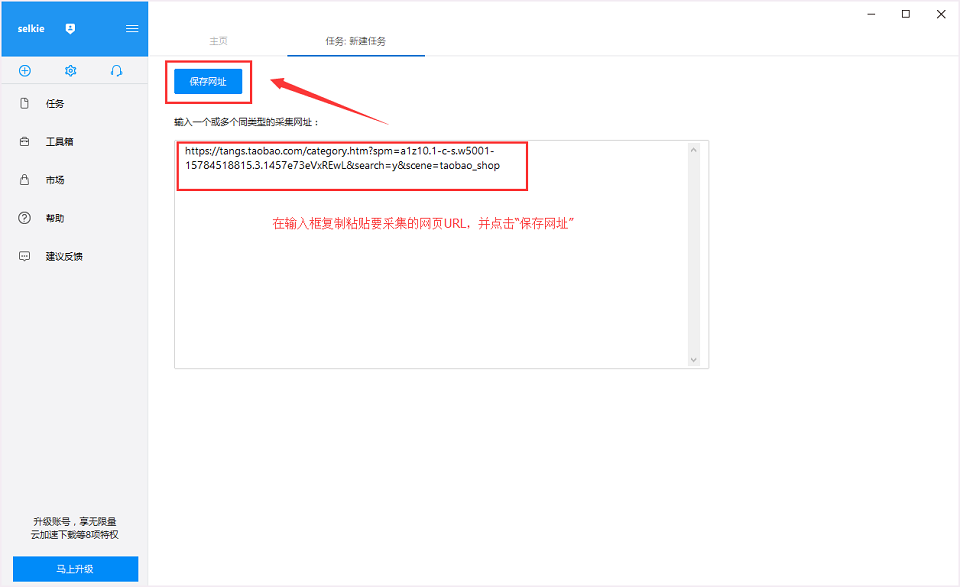
别再手动复制网页数据啦!Python爬虫,普通人零成本抓取行业公开数据...你每天累死累活地做数据,而别人通过挂机爬虫全自动采集,人和人的差距,往往就是由一个工具拉开的。 很多人想获取行业数据,通常有三条老路: ❌手动一页页复制网页数据,忙活一天8小时,数据还容易出错; ❌花钱购买专业数据平台会员,一年要花费大几千甚至上万,普通人根本承受不起;...

AI抓取技术深度剖析:稳定代理助力高效安全数据采集现在的互联网环境里,网页结构总在变,反爬机制也越来越多,传统数据采集技术日子不好过。研究者和工程师们开始琢磨AI驱动的自适应数据采... 动态调整解析规则和数据提取逻辑,这样就能减少因为页面结构变动导致的数据丢失问题。为了解决IP限制,系统会用爬虫代理技术,通过动态切...
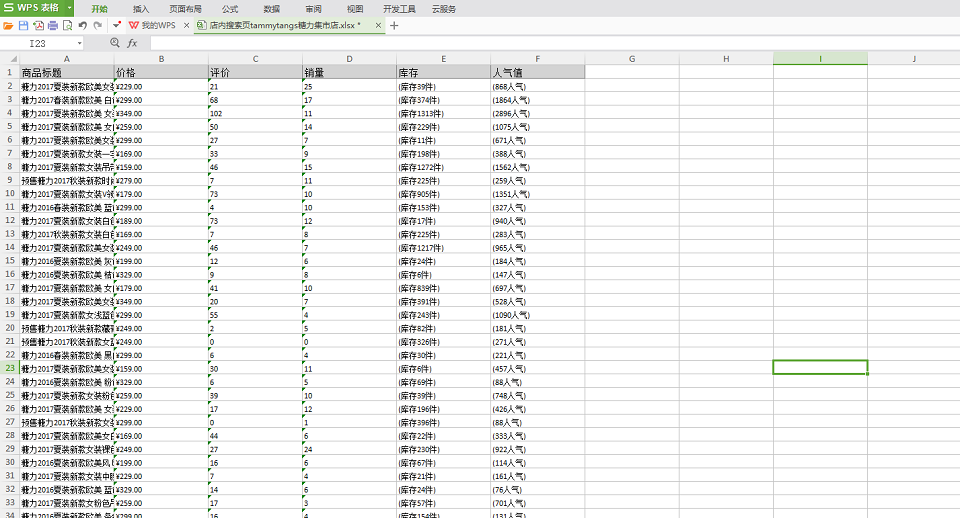
ˋ^ˊ 想要获取行业公开数据?Python爬虫是最优选择你每天累死累活做数据,别人挂机爬虫全自动采集,人和人的差距,往往就是一个工具拉开的。 很多人想找行业数据,无非三条老路: 很多人想找行业数据,无非三条老路: ❌ 手动一页页复制网页数据,一天忙活8小时,数据还容易出错; ❌ 花钱买专业数据平台会员,一年大几千上万,普通人根本用...

网页内容提取与反爬虫技术全解析网页内容提取技术详解 网页内容提取是网络数据采集的核心技术,通过解析HTML结构、提取文本信息,为后续的数据分析和处理提供基础。现代网页内容提取技术包括DOM解析、正则表达式匹配、XPath定位等多种方法,能够精准获取目标数据。 反爬虫技术发展历程 反爬虫技术随着互...

1分钟浏览科技圈热搜:网页内容提取与反爬虫技术未来爬虫技术将更加注重数据安全与隐私保护,遵守相关法律法规。同时,爬虫技术将在金融、医疗健康等领域发挥更大作用,不仅限于数据抓取,还将参与到数据分析和决策支持中,为各行业提供更有价值的服务。 网页数据采集工具使用技巧 掌握网页数据采集工具的使用技巧能够大幅提高...
开发者如何通过AI,合法抓取数据?但“姿势”得对:开发者如何通过 AI 合法抓取数据?》,头图来自:AI生成最近在圈子里流传着一句话:“爬虫写得好,牢饭吃到饱。”虽然是玩笑,但也反映了当下数据采集面临的严峻法律环境。AI的出现让数据抓取变得前所未有的简单——利用LLM解析复杂网页、自动绕过反爬、甚至模拟...

+^+ OpenClaw最强外挂出现:小龙虾抓不到数据有救了!克雷西 发自 凹非寺量子位 | 公众号 QbitAI用OpenClaw挂机,抓取网页时频频翻车的烦人bug终于有解了。一个名为Scrapling的数据采集神器,几乎一夜之间就成了OpenClaw的“最强外挂”。这玩意儿不仅能穿透各种防爬虫的网页护盾,还能把网上杂乱的网页源码生扒下来,直接清洗成干...

西柚加速器部分文章、数据、图片来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知删除。邮箱:xxxxxxx@qq.com


