怎么识别视频里的文字_怎么识别视频里的文字
*** 次数不足,请联系开发者***

国家反诈AI App上线:文字+语音+视频拆解骗局,实测5秒识别‘公检法’...…每个环节配短视频演示,连骗子常用的‘保密协议’话术模板都列出来,还能一键生成举报截图。更实在的是,它支持语音实时转文字+自动分析... 平均识别时间4.7秒,准确率98.2%。背后不是单一大模型,而是融合了司法文书库、12381预警数据流、全国反诈中心话术样本的多模态系统。...

时代的眼泪 显微镜下观察CED光盘:竟真看到了视频画面!快科技3月16日消息,科技博主Tech Tangents(TT)近日用显微镜探索一种已被遗忘的模拟视频格式,意外发现其碟片表面竟可直接辨识出存储的视频图像和文字。CED(电容式电子影碟)是上世纪与VHS、Betamax并存的短命视频格式,虽然外观酷似人们熟悉的激光影碟(LaserDisc),但其底层...
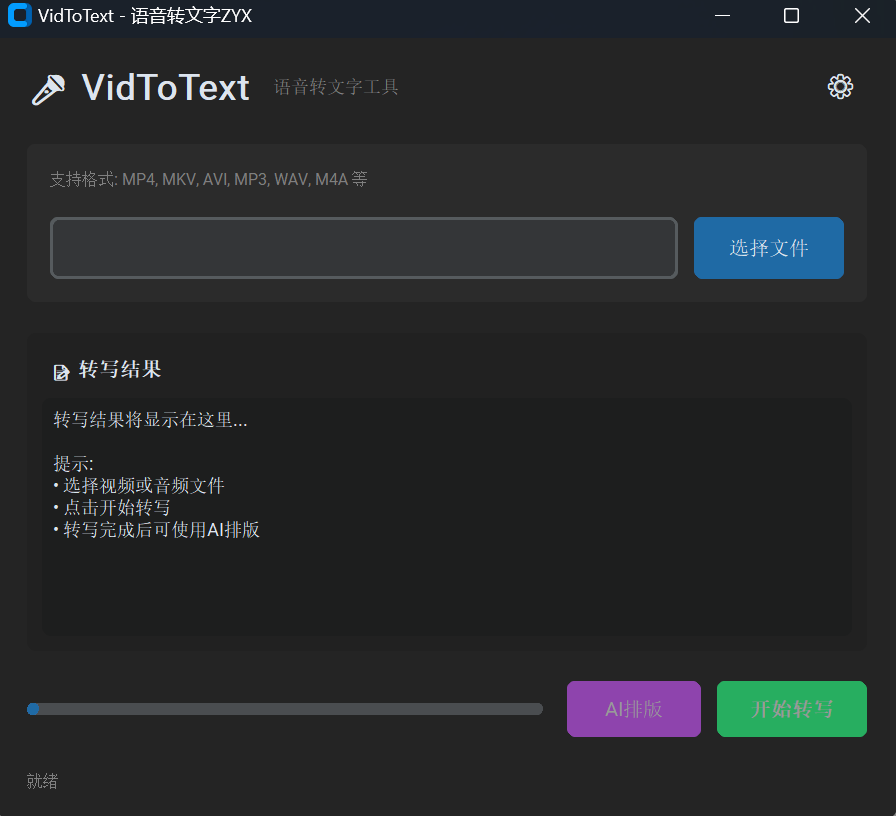
∩﹏∩ 从Find X到OPPO Watch X3:OPPO展台实测AI一键闪记+实景对话有多强举着手机拍‘AI一键闪记’怎么三秒存下会议PPT里的二维码、自动归类进‘工作-待跟进’文件夹。现场工作人员没开口讲解,只轻轻点一下屏幕,视频片段、网页文字、甚至外卖小哥递来的取餐码,全被识别、提取、打标、归档。这不是演示稿里的特效,是真机跑出来的系统级能力。后...

狂揽200余项SOTA!阿里推出全模态大模型Qwen3.5-Omni快科技3月30日消息,阿里今日正式发布千问新一代全模态大模型Qwen3.5-Omni。据悉,Qwen3.5-Omni采用混合注意力MoE架构,可实现图片、视频、语音、文字等全模态内容的输入与输出。在音视频理解、识别、交互等215项任务中,Qwen3.5-Omni取得SOTA(性能最佳),超越Gemini-3.1...
o(╯□╰)o 
字节悄悄转向企业服务,豆包日亏3000万!普通用户的福利终结?更扎心的是维持运转的算力成本每天高达数千万——文字聊天人均每天15-20分钟才几分钱,但开启图片识别、语音视频功能后,成本直接翻几十... 字节可能还得重新琢磨:怎么让2亿用户心甘情愿为"智能陪伴"买单?据第一财经报道,当前模型处理复杂任务时仍存在不稳定现象,大众对AI工具...
西柚加速器部分文章、数据、图片来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知删除。邮箱:xxxxxxx@qq.com
上一篇:怎么识别视频里的文字
下一篇:怎么识别视频里的文字是什么字体


