爬虫网页源代码_爬虫网页源代码怎么看
*** 次数不足,请联系开发者***

o(╯□╰)o 别再手动复制网页数据啦!Python爬虫,普通人零成本抓取行业公开数据...只需10行Python代码,10秒就能完成别人一天的工作量。 你每天累死累活地做数据,而别人通过挂机爬虫全自动采集,人和人的差距,往往就是由一个工具拉开的。 很多人想获取行业数据,通常有三条老路: ❌手动一页页复制网页数据,忙活一天8小时,数据还容易出错; ❌花钱购买专业数据平...

OpenClaw最强外挂出现:小龙虾抓不到数据有救了!克雷西 发自 凹非寺量子位 | 公众号 QbitAI用OpenClaw挂机,抓取网页时频频翻车的烦人bug终于有解了。一个名为Scrapling的数据采集神器,几乎一夜之间就成了OpenClaw的“最强外挂”。这玩意儿不仅能穿透各种防爬虫的网页护盾,还能把网上杂乱的网页源码生扒下来,直接清洗成干...
∪▽∪ 《时代》杂志为 AI 爬虫设计 Markdown 格式,且整合广告内容而面向 AI 爬虫则提供单独、带有广告的版本。面向 AI 爬虫的页面采用 Markdown 格式。相比普通网页中的图片、菜单和显示代码,Markdown 更便于基于文本的 AI 系统解析文章和链接。施马尔巴赫测试通过更改 User-Agent(用于标识访问网站的浏览器或爬虫类型)测试《时代》网站。测...
Python爬虫批量下载图片、文档、素材实操全过程批量下载图片、文档、素材,Python 爬虫实操全过程 做 PPT 找配图、自媒体找素材、备课存课件、设计找高清图。 一页网页几十张图,手动右键另存,最少折腾十几分钟。 PDF、Word 模板挨个点开下载,手指点到发酸,效率极低。 网上爬虫教程大多坑人:代码残缺、运行报错、只教单张图...
≥0≤ 
批量下载图片、文档、素材,Python 爬虫实操全过程做PPT找配图、自媒体找素材、备课存课件、设计找高清图,面对网页上那一页几十张的图片,要是手动右键一张张另存,没个十几分钟根本搞不定。而PDF、Word模板挨个点开下载,手指点到发酸,效率低到不行。网上的爬虫教程好多都坑人,代码残缺不全、运行还报错,就教个单张图下载...
1分钟浏览科技圈热搜:网页抓取与网站访问问题全解析网络连接问题 爬虫URL怎么才算真正有效?有哪些快速验证方法?验证爬虫URL是否有效需结合多种技术手段:一是用浏览器开发者工具观察实际网络请求与响应,尤其注意含中文等特殊字符时需用urllib.parse.urlencode进行UTF-8编码;二是对比网页源代码(ViewSource)与DOM渲染结果,判...
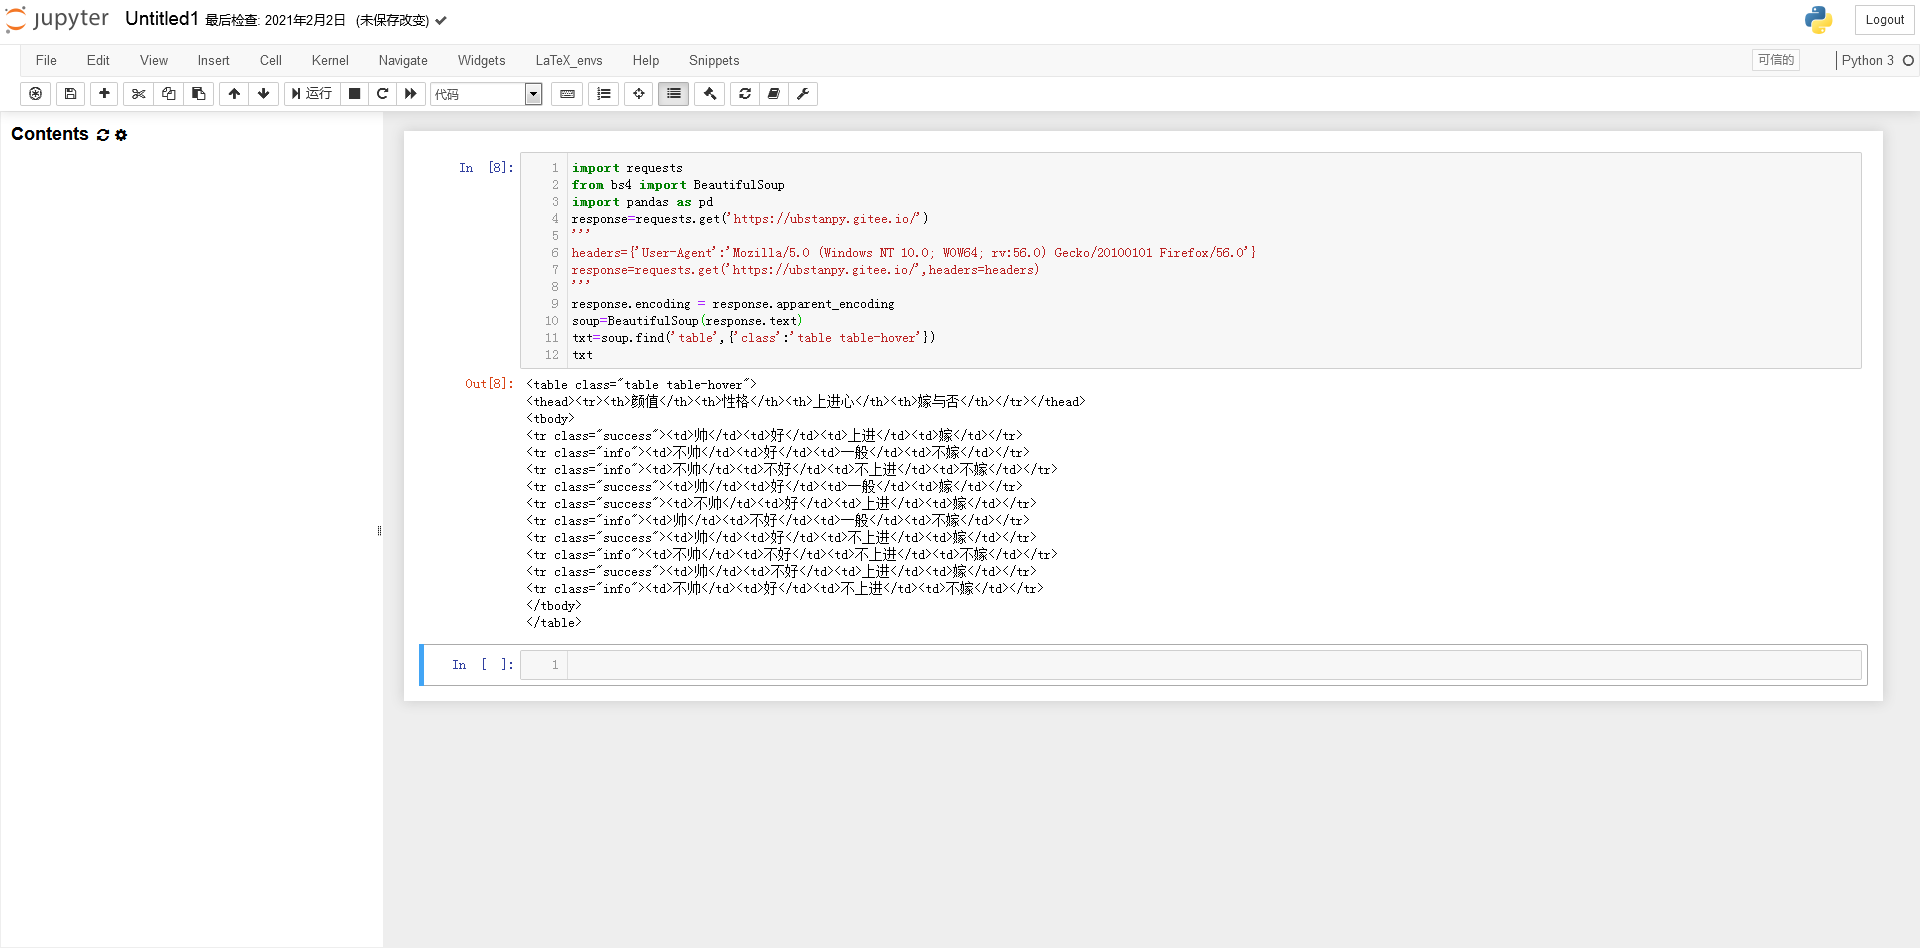
个人开发者福音!阿里云加量不加价升级,Standard套餐白送7类Agent...网页解析、代码解释器、语音合成、语音识别、图像生成。不是试用,不是限时,是每月直接到账的固定额度。比如Standard用户,光网页解析每月就送1000次,做爬虫、做信息聚合、做RAG数据预处理,不用再单独买服务、配密钥、算token,点开API就能用。 以前搭一个能联...
西柚加速器部分文章、数据、图片来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知删除。邮箱:xxxxxxx@qq.com
上一篇:爬虫网页源代码怎么看
下一篇:爬虫网页源代码


