爬虫网页_爬虫网页
\ _ / *** 次数不足,请联系开发者***
ˋ﹏ˊ 网页内容提取与反爬虫技术全解析网页内容提取技术详解 网页内容提取是网络数据采集的核心技术,通过解析HTML结构、提取文本信息,为后续的数据分析和处理提供基础。现代网页内容提取技术包括DOM解析、正则表达式匹配、XPath定位等多种方法,能够精准获取目标数据。 反爬虫技术发展历程 反爬虫技术随着互...
●▂● 
别再手动复制网页数据啦!Python爬虫,普通人零成本抓取行业公开数据...而别人通过挂机爬虫全自动采集,人和人的差距,往往就是由一个工具拉开的。 很多人想获取行业数据,通常有三条老路: ❌手动一页页复制网页数据,忙活一天8小时,数据还容易出错; ❌花钱购买专业数据平台会员,一年要花费大几千甚至上万,普通人根本承受不起; ❌下载官方行业报告,数据...
1分钟浏览今日热搜:网页内容提取与反爬虫技术为网页内容自动化处理提供了有效解决方案。 网站503错误处理策略 503错误表示服务器当前无法处理请求,通常由服务器暂时过载或维护引起。在爬虫开发中,503错误可能源于服务器负载过高、请求频率过快或反爬虫机制触发。应对策略包括:合理控制并发线程数量,设置请求间隔避免...
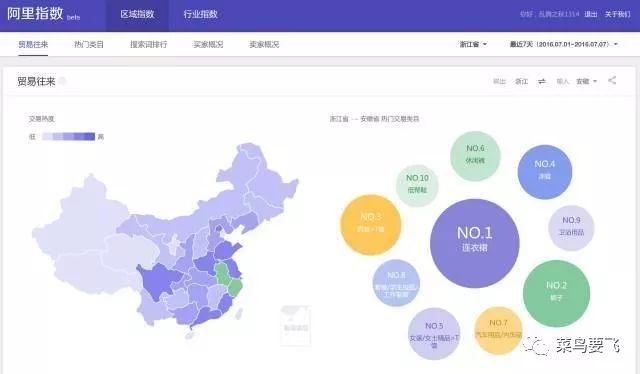
1分钟浏览科技圈热搜:网页内容提取与反爬虫技术article-extractor 可以处理各种复杂的网页结构,为内容采集、信息整理和数据分析提供高效的技术支持。无论是静态页面还是动态加载的内容,都能准确提取出用户需要的核心信息。 网站反爬虫验证码保护机制 验证码反爬虫机制是网站保护数据安全的重要手段。验证码的英文是Captch...
(#`′)凸 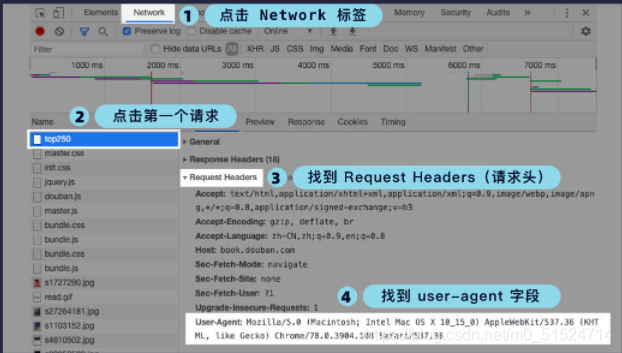
⊙△⊙ Cloudflare 计划默认禁止 AI 代理与训练爬虫访问广告页面IT之家 7 月 2 日消息,互联网基础服务企业 Cloudflare 当地时间 1 日宣布细化网络爬虫屏蔽管理,根据其行为对爬虫机器人赋予搜索、代理、训练等一系列标签,并计划在 2026 年 9 月 15 日默认禁止 AI 代理与训练爬虫访问含广告的网页。Cloudflare 表示,大多数网站所有者都希望自己的内...

⊙▽⊙ Python爬虫批量下载图片、文档、素材实操全过程批量下载图片、文档、素材,Python 爬虫实操全过程 做 PPT 找配图、自媒体找素材、备课存课件、设计找高清图。 一页网页几十张图,手动右键另存,最少折腾十几分钟。 PDF、Word 模板挨个点开下载,手指点到发酸,效率极低。 网上爬虫教程大多坑人:代码残缺、运行报错、只教单张图...
>▽< 
《时代》杂志为 AI 爬虫设计 Markdown 格式,且整合广告内容而面向 AI 爬虫则提供单独、带有广告的版本。面向 AI 爬虫的页面采用 Markdown 格式。相比普通网页中的图片、菜单和显示代码,Markdown 更便于基于文本的 AI 系统解析文章和链接。施马尔巴赫测试通过更改 User-Agent(用于标识访问网站的浏览器或爬虫类型)测试《时代》网站。测...

Cloudflare推AI爬虫付费新规,2026年起禁爬广告页面所有带广告的网页将对AI爬虫集体关门。特别是那些“身兼数职”的混合型爬虫——比如白天假装是搜索引擎,晚上偷偷训练AI模型的家伙,必须亮明真实身份才能通行。Cloudflare直接给爬虫打上搜索、代理、训练等标签,混水摸鱼的直接触发拦截机制。某新闻网站编辑就拍手叫好:“终...

批量下载图片、文档、素材,Python 爬虫实操全过程做PPT找配图、自媒体找素材、备课存课件、设计找高清图,面对网页上那一页几十张的图片,要是手动右键一张张另存,没个十几分钟根本搞不定。而PDF、Word模板挨个点开下载,手指点到发酸,效率低到不行。网上的爬虫教程好多都坑人,代码残缺不全、运行还报错,就教个单张图下载...
?ω? 
1分钟浏览今日热搜:网站反爬虫与数据抓取技术发展密码爆破和爬虫抓取。常见的验证码类型包括字符验证码、计算型验证码、滑动验证码、点击验证码和视觉验证码。其核心原理是通过Session机制保存验证信息,用户提交后与服务端存储的验证码进行比对,确保操作由真实人类完成。 网页内容提取技术:从静态解析到动态渲染的演进 网...

西柚加速器部分文章、数据、图片来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知删除。邮箱:xxxxxxx@qq.com


